没有标准答案,不等于没有参照
现有反馈各有瓶颈:人工反馈昂贵且带有偏差;模型评审依赖更强的老师,本身也会出错;可验证奖励只覆盖写得出判题器的任务。
但即使没有标准答案,正确的输出仍要满足一些关系:保留输入里的信息,与模型在擅长的相关任务上的结论一致,所说的内容能在输入中找到依据。错误的输出往往会破坏这些关系,而检查一个关系,通常比直接给出答案容易。
奖励不一定来自知道答案的人,也可以来自正确答案必须满足的关系。
这里的“结构”,指的就是这类不知道答案也能检查的关系。把结构变成可计算的检查,再用作奖励或偏好,是我们三项工作的共同出发点。
结构藏在哪里:三个实例
这样的结构分别藏在任务本身、模型内部,以及输入与输出之间。
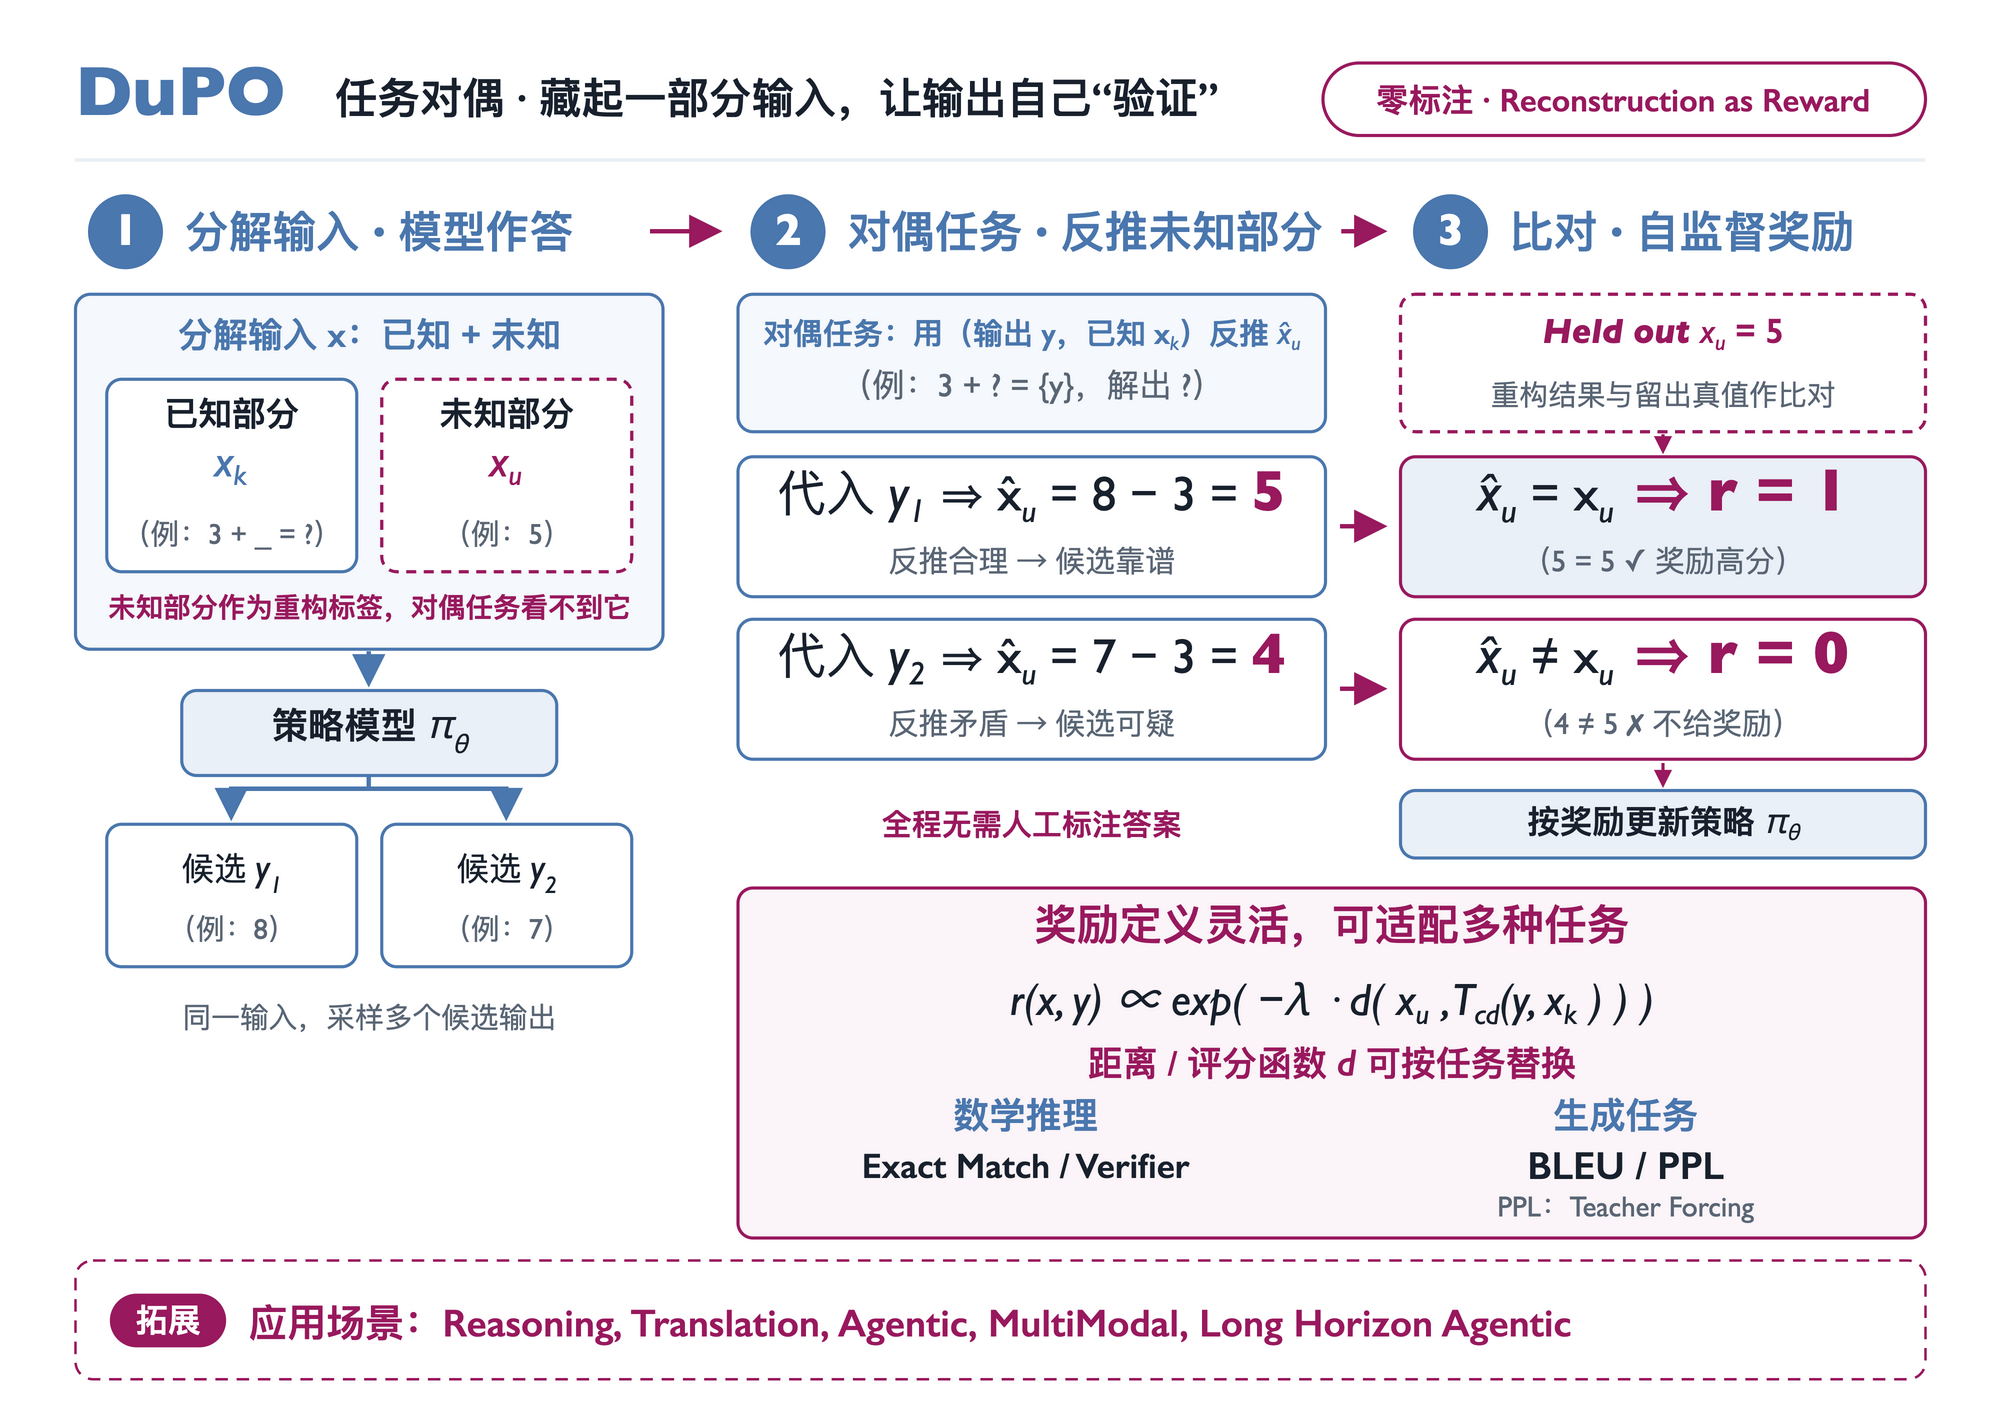
任务的对偶:正确的输出能把输入找回来DuPO
翻译可以用回译检查,但多数任务不可逆:只看答案 8,推不回原题是 3 + 5 还是 10 − 2。DuPO 只找回输入的一部分:把 5 藏起来,用候选答案和已知的“3 + _”反推。答案 8 推回 5,与原值一致;答案 7 推出 4,对不上,得不到奖励。已知部分把反推约束成一道小题,藏起的事实成了评分依据;藏什么、怎样比较,都可以随任务替换。
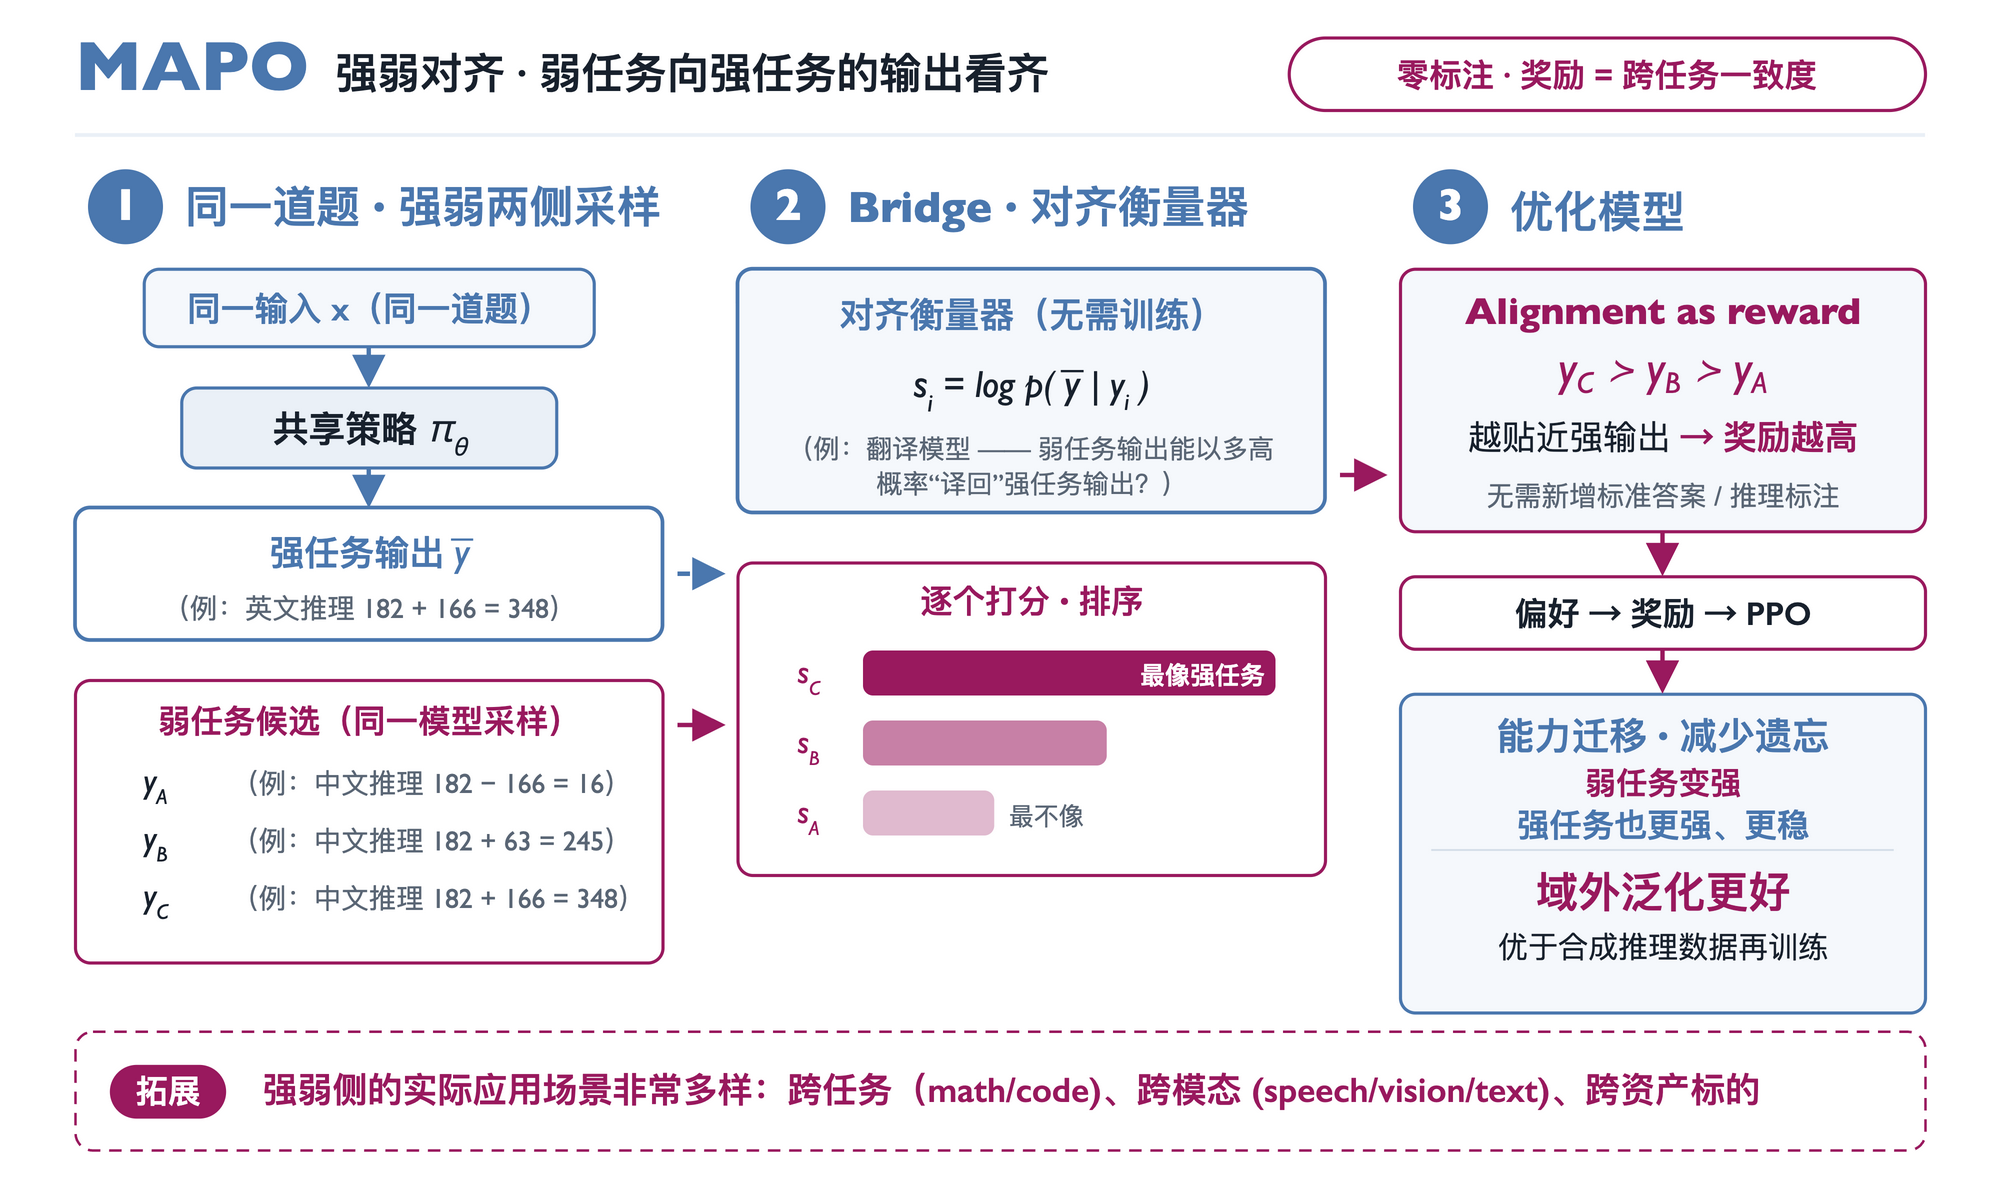
模型的强弱:弱项向同一模型的强项看齐MAPO
同一个模型在相关任务上的能力往往不均衡。MAPO 让强任务提供参照、弱任务接受优化:对同一个输入,弱任务的输出与强任务的输出越一致,奖励越高;衡量一致性的模型不必会解题,只需判断两段输出是否在说同一件事。在已验证的跨语言数学推理中,较弱语言的推理明显提升,在未参与训练的测试集上同样成立,作为参照的语言在域外测试上也随之提高。跨任务、跨模态的迁移有待验证。
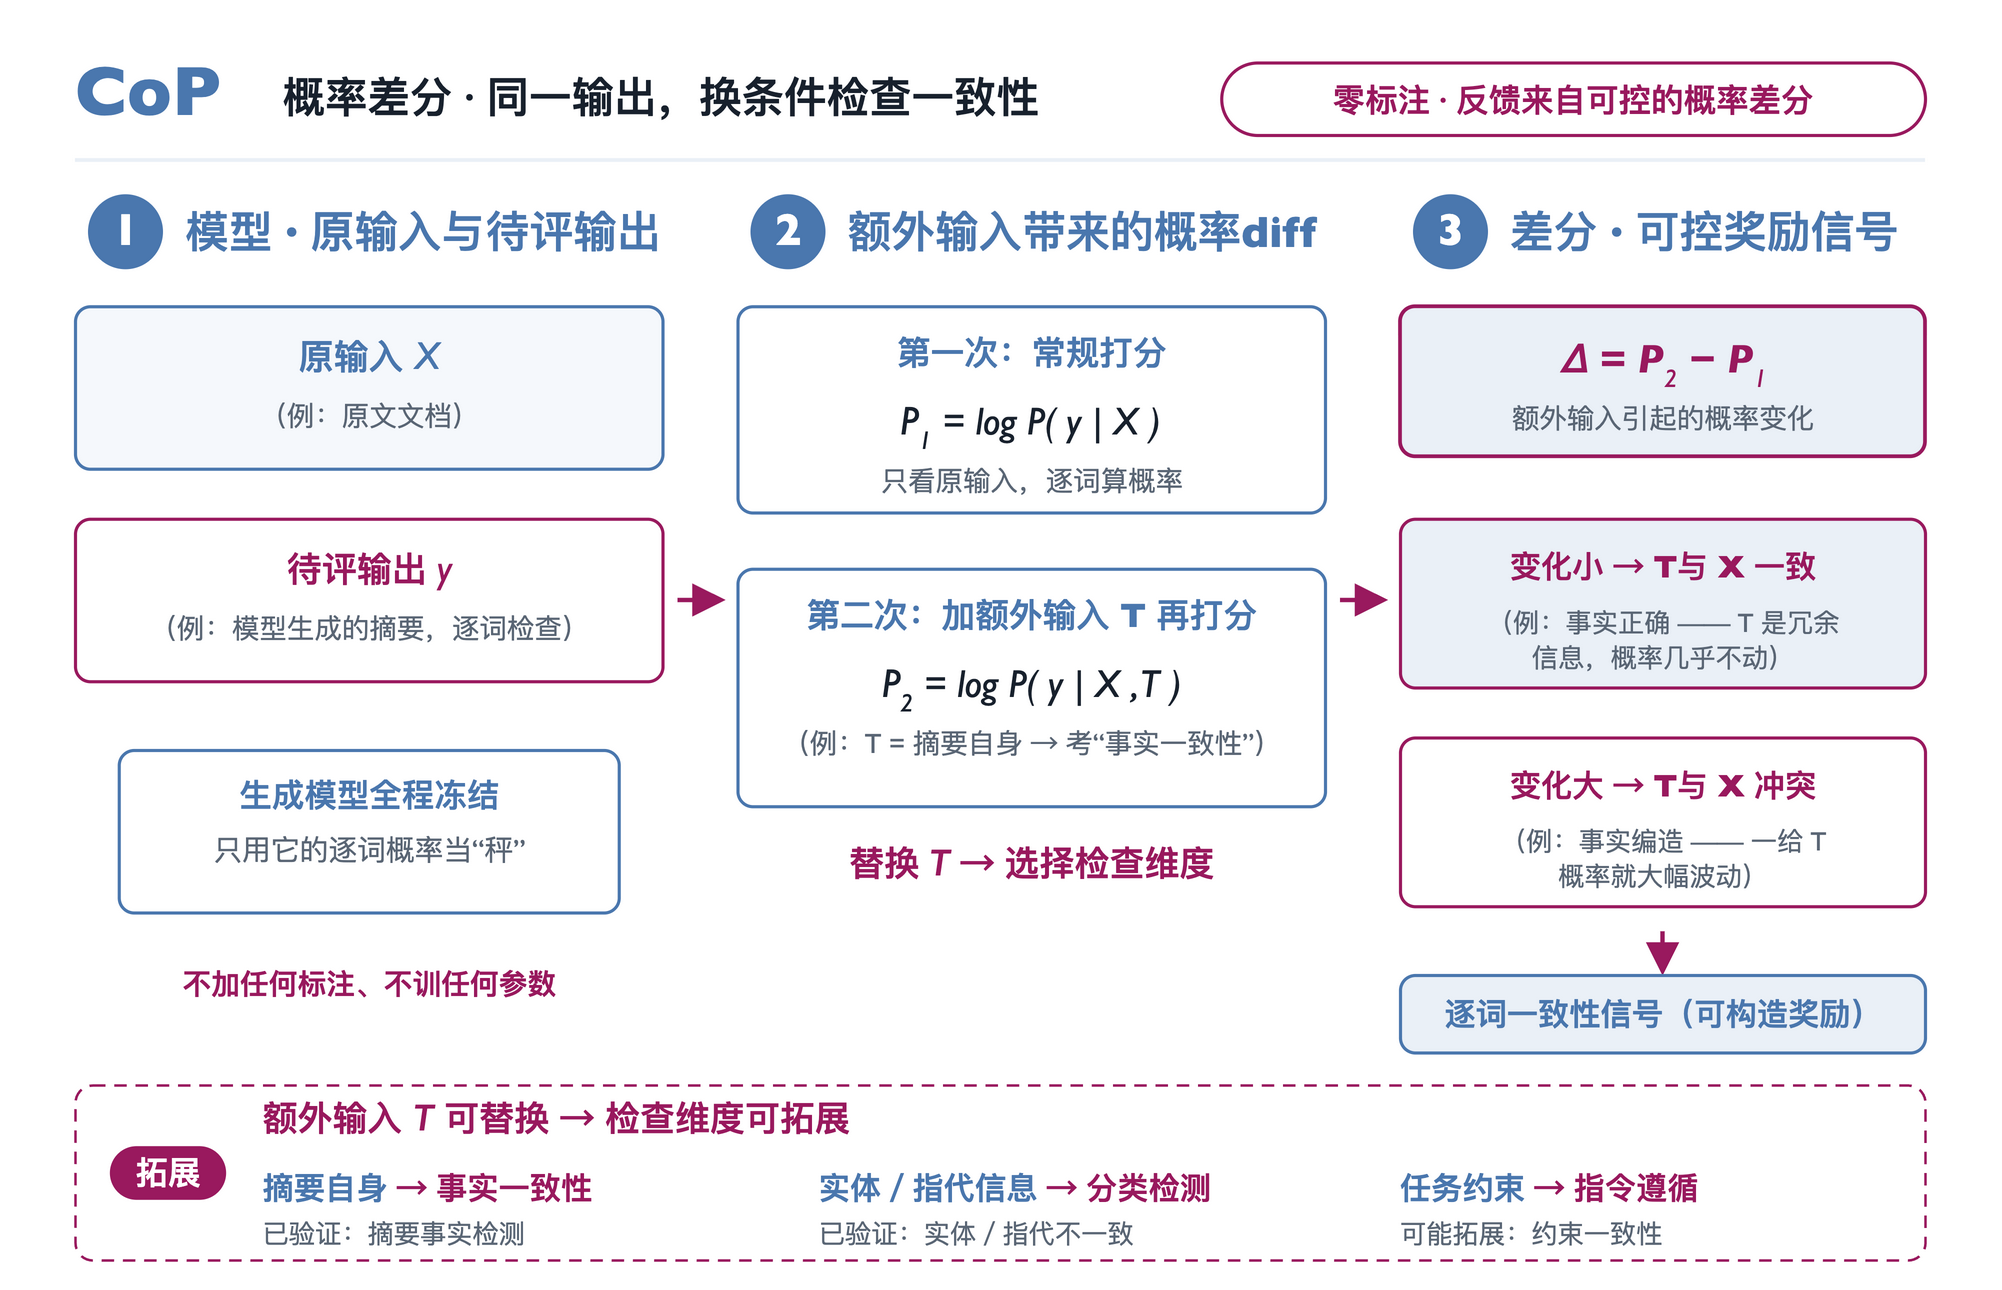
输入与输出:内容要有来源CoP
流畅的摘要也可能编造事实,而生成概率分不清“有原文支持”和“读起来顺”。CoP 让同一个冻结模型给同一份摘要打两次分:一次只看原文,一次再附上提示,最简单的提示就是这份摘要本身。原文写收入增长 5%,摘要写成 50%:附上提示后,“50%”的概率明显上升,说明它要靠提示才说得出口;有原文支持的词,概率几乎不变。换一种提示,就换了检查的维度,例如专查实体或指代错误。论文验证的是检测效果,用作训练奖励尚待验证。
通用模板:参照、关系与检查
三个实例可以写成同一个模板:一个比被检查的输出更可靠、且独立于它的参照;一条正确输出与参照之间必须成立的关系;一个比原任务容易的检查。
| 参照 | 必须成立的关系 | 检查 | |
|---|---|---|---|
| DuPO | 被藏起的那部分输入 | 输出加上已知部分,能推回它 | 反推,再与原值比较 |
| MAPO | 同一模型在强任务上的输出 | 弱任务的输出与它表达同一推理 | 对齐模型打分 |
| CoP | 原文 | 内容都能由原文解释 | 加提示前后的概率差 |
要让这样的奖励可靠,有几条反复出现的要求:
- 参照不能泄露。对偶题里不能出现被藏起的值,否则反推就成了照抄。
- 检查要比任务容易。检查者不必整体更强,只要在它检查的维度上可靠。
- 堵住捷径。只奖励“回译像原文”,照抄原文也能得高分;所以 LongDu 把对偶用于长文翻译时,先检查译文的语言。
- 独立验收。奖励上升不等于模型变好,提升必须出现在未参与训练的评测上。
- 让检查自动产生。对偶题由程序生成并自动筛选。人力花在设计结构上,而不是逐条标注,这才是能规模化的部分。
自进化:让监督和模型一起变强
在 DuPO 里,作答和反推可以由同一个模型完成;在 MAPO 里,参照来自模型自己的强项。模型变强,它构造的检查也可能随之变强,训练不必止步于某个固定评审的水平。被藏起的事实和原文不随模型改变,是这个循环里固定不动的参照,使它不只是在强化模型自己的看法。
但一致不等于正确:强项也会出错,两种语言也可能错到同一处。生成者与检查者同源时,共同盲点最难发现,需要独立评测,也许还需要不同结构的检查互相校验。
我们希望规模化的不只是模型回答问题的能力,也包括它构造、检验和改进自身监督的能力。
换一个任务,先问三个问题
- 正确的输出必须保留什么?把它藏起来,看能否找回。比如代码:藏起需求里的一个参数,看能否从程序反推。
- 模型在哪里已经做得好?让相关的弱项向它看齐。比如从数学推理到代码,从文本到语音或图像。
- 输出的内容都有来源吗?看它是否要靠额外提示才说得出口。比如用任务约束检查指令遵循。
然后追问两点:这个检查比任务本身容易吗?有没有不提升质量也能得分的捷径?
已验证数学推理、翻译、长文翻译、跨语言推理、摘要事实检测。
可能拓展上面三个例子,以及智能体、长程任务与多模态。
这三个问题目前还要靠人回答。能否让模型自己提出并筛选结构,是自进化接下来要回答的问题。
继续阅读
- DuPO(ICLR 2026):把“藏起一部分输入”变成通用奖励;7B 翻译模型在 28 种语言、756 个方向的评测中,三项指标均超过 Qwen3-235B-A22B。arXiv · OpenReview
- LongDu(ACL 2026):对偶奖励用于长文翻译时会怎样被钻空子,又怎样堵住。论文
- MAPO(ACL 2024):只用跨语言一致性作偏好信号,在未参与训练的测试集上,十种语言的平均准确率提高 16.2 个百分点。论文 · 代码
- CoP(AAAI 2023):不训练,只比较两次打分,就能逐词定位摘要中的幻觉。论文 · arXiv · 代码
代表性结果与口径
- DuPO(arXiv v1):Qwen3-4B 在 AMC23、AIME24、AIME25 上的平均准确率 77.2% → 83.6%;不训练、只在推理时重排候选,AIME24/25 平均 68.4% → 77.7%;Seed-X-7B 的 COMET 86.96 → 89.09。
- LongDu:Qwen3-4B-Instruct 长文翻译 BLEU 49.21 → 55.10;问答模型基于往返翻译的文档回答原文问题,错误率 2.18% → 1.03%。
- MAPO:MathOctopus-7B 在 MSVAMP 上十种语言的平均准确率 41.2% → 57.4%(m-RFT 为 48.7%);在原监督微调数据域 MGSM 上,m-RFT 的平均准确率下降 5.1 个百分点,MAPO 提高 2.1 个百分点。
- CoP:XSum 上零样本逐词检测 F1 为 63.72(直接用生成概率为 59.25);只训练 0.08M 参数、用 300 条标注达到 66.56。
以上均为论文报告值,未独立复现。正文和图中的 3 + 5、5% 与 50%、中文候选都是讲解用的简化示例。“零标注”指不新增答案、推理过程或偏好标注,不是不需要训练数据。